Les algorithmes #
The etymology of program is pro ‘before’ + graphein ‘write’. I think of programming as making a plan that will be executed in the future, something that every human does from time to time. The hard part is that a computer has to execute the plan, and computers are incredibly stupid. Dealing with such stupidity requires more patience and determination than many people have. (Peter Turney)
Préalables #
Dans ce cours, nous présentons les notions de manière exhaustive, avec beaucoup d’exemples et des activités d’approfondissement. Néanmoins, nous supposons dans ce cours que vous avez complété les mathématiques du collégial et que vous avez de bonnes aptitudes en ce qui a trait aux raisonnements formels. Dans ce premier module, vous aurez à exprimer la solution de certains problèmes en terme de variables, de boucles et d’embranchement. Il ne s’agit pas de notions avancées : vous devriez être familier avec ces notions. Les boucles font partie implicitement du calcul d’une somme ou d’un produit scalaire. Les variables en informatique sont une notion voisine des variables en algèbre. Les embranchements sont des notions de base en logique élémentaire. Nous supposons une familiarité avec ces notions. Vous êtes responsables de vous assurez que vous avez la préparation nécessaire pour suivre le cours INF 1220.
Introduction #
Le processus systématique de résolution d’un problème donné s’appelle algorithme. La notion d’algorithme formel est vue dans le cadre des cours de mathématiques du secondaire, notamment dans le contexte de la théorie des graphes et des algorithmes d’optimisation. Comme point de départ dans le cours INF 1220, nous revisitons et approfondissons brièvement cette notion fondamentale.
Un algorithme est donc une suite d’actions pour répondre à un problème de traitement de l’information. Ces actions peuvent être mathématiques (ex. somme = a + b), de contrôle (ex. SI a > b ALORS) ou d’itérations (ex. TANT QUE a > b FAIRE). Pour décrire ces algorithmes, il existe également plusieurs formalismes, certains utiliseront des formalismes mathématiques alors que d’autres utiliseront des pseudocodes. Encore là dans plusieurs formats pour représenter un pseudocode (ou pseudo-code), il n’existe pas de normes uniques!
En cuisine, une recette est un exemple d’algorithme si celle-ci comporte une séquence d’instructions précises. Pouvoir rédiger de manière précise une recette afin que d’autres cuisiniers puissent reproduire la même séquence d’opération est de facto de la programmation informatique. Si vous avez fait l’expérience du manuel de recette de quelqu’un d’autre (par ex., votre grand-mère), vous avez peut-être découvert qu’il peut être difficile de suivre des consignes de quelqu’un d’autre surtout quand celles-ci ne sont pas suffisamment précises. Une recette de cuisine est du pseudocode.
Avant l’invention du GPS, il était commun d’expliquer à des amis ou des parents comment se rendre à un lieu donné en suivant une série d’instructions. Il arrivait souvent, malheureusement, que ces instructions n’étaient pas assez précises et que les gens se perdent. Expliquer à quelqu’un comment se rendre à un lieu donné est un exemple de programmation informatique. Votre explication est du pseudocode.
Il est essentiel de comprendre ce qu’est le pseudocode: il s’agit d’une façon de décrire un algorithme afin que d’autres êtres humains puissent vous comprendre. Il faut donc interpréter le pseudocode en utilisant son jugement humain de la même façon que vous interprétez tout autre texte ou discours. Pouvoir lire un algorithme, décrit en pseudocode, est une compétence essentielle en informatique. Il faut être capable de comprendre d’autres informaticiens sans nécessairement exiger que ceux-ci utilisent du code informatique dans un langage particulier (par ex., Java). Programmer et faire de l’informatique exige de pouvoir bien communiquer avec les autres informaticiens indépendamment de langages de programmation spécifiques.
Pour un programmeur d’expérience, s’exprimer à l’aide d’un pseudocode est chose aisée. Pour le commun des mortels, c’est un peu plus difficile. La blague suivante illustre le problème.
Une femme demande à son programmeur de mari : « Va au supermarché acheter une bouteille de lait. Et si ils ont des œufs, prends en 6 ». Le mari revient avec six bouteilles de lait. Sa femme lui demande pourquoi il a pris six bouteilles. « Parce qu’ils avaient des oeufs » répond-il.
Quand on rédige un pseudocode, il faut tout spécifier, comme si on s’adressait à quelqu’un qui prend tout littéralement, sans aucun jugement. Pour devenir un programmeur, pour penser comme un programmeur, il faut s’habituer à rédiger des séquences d’instructions précises. La lecture et la rédaction de pseudocodes relativement simples peut être une bonne pratique.
Le pseudocode est destiné à être lu par l’humain, et il peut être écrit de diverses manières tant que l’humain le comprend. Le cours ne vise pas à vous permettre de comprendre une syntaxe particulière de pseudocode, mais bien le pseudocode en général.
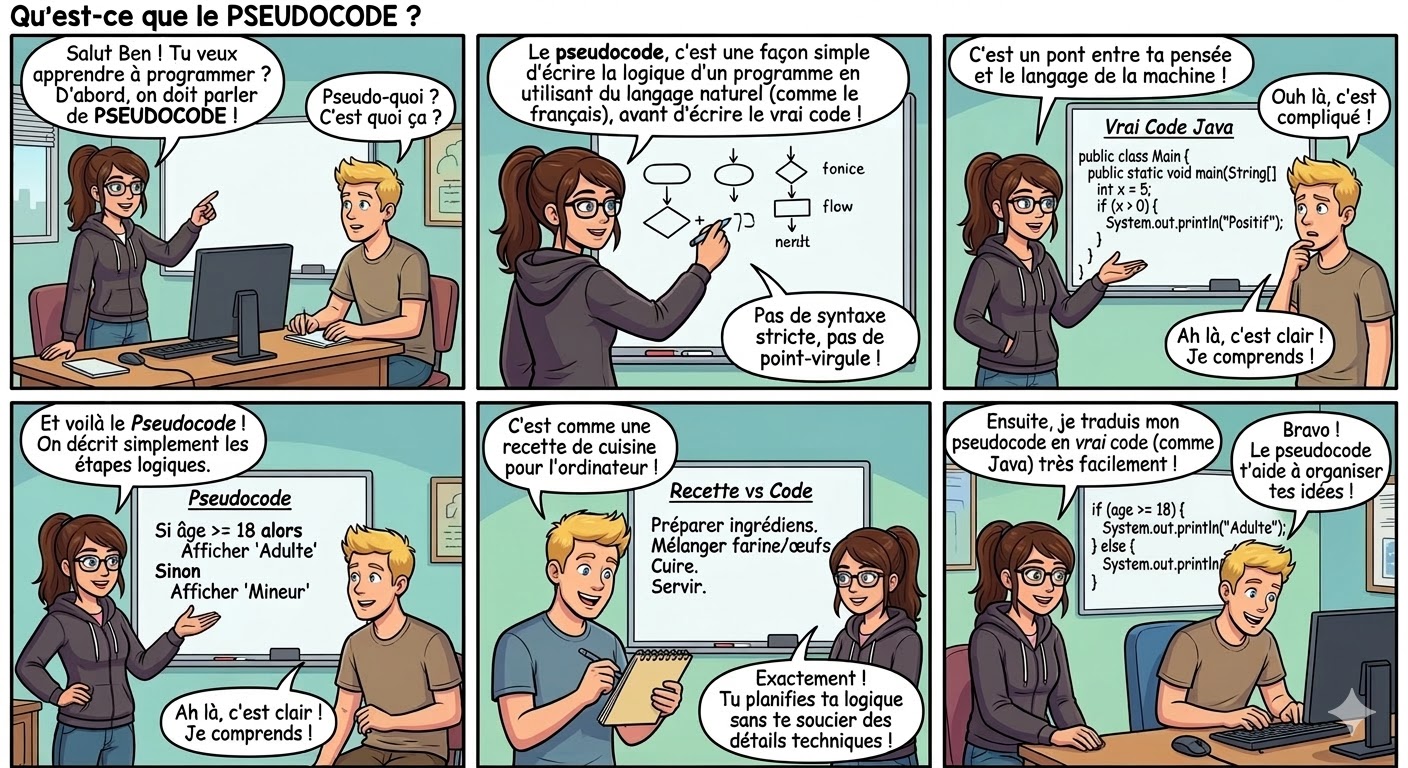
Qu’est-ce qu’un algorithme ? #
Un algorithme est une suite finie et ordonnée d’instructions permettant de résoudre un problème ou d’accomplir une tâche spécifique. Il s’agit d’une méthode systématique, exprimée de manière précise, qui garantit un résultat correct lorsqu’elle est exécutée. Les algorithmes sont au cœur de l’informatique, car ils décrivent comment un programme doit fonctionner pour atteindre un objectif.
Exemples d’algorithmes dans la vie quotidienne :
- Une recette de cuisine (série d’étapes pour préparer un plat).
- Les instructions pour assembler un meuble.
En informatique, un algorithme peut, par exemple, trier une liste de nombres ou calculer le chemin le plus court entre deux points.
Qu’est-ce que le pseudocode ? #
Le pseudocode est une manière d’écrire un algorithme en utilisant un langage simplifié, proche du langage naturel, mais structuré comme un programme informatique. Il n’est pas destiné à être exécuté directement par un ordinateur, mais sert à décrire la logique d’un algorithme de manière claire et compréhensible, indépendamment d’un langage de programmation spécifique.
Le pseudocode utilise des conventions comme :
SI,ALORS,SINONpour les conditions.POUR,TANT QUEpour les boucles.- Des instructions comme
écrireoulirepour les entrées/sorties.
Exemple de pseudocode pour calculer la somme de deux nombres :
lire nombre1
lire nombre2
somme ← nombre1 + nombre2
écrire somme
Le pseudocode permet aux programmeurs de planifier la logique avant de la traduire dans un langage comme Python, C++ ou Java.
En résumé, un algorithme est une méthode pour résoudre un problème, tandis que le pseudocode est un outil pour exprimer cet algorithme de manière claire et universelle. Ces deux concepts sont essentiels pour concevoir des solutions informatiques efficaces.
Variables et valeurs #
Une variable en informatique est un espace de stockage nommé qui contient une valeur. Elle peut être vue comme une boîte étiquetée dans laquelle on place une donnée, et cette donnée peut changer au cours de l’exécution d’un algorithme. Les variables permettent de manipuler des informations de manière dynamique, en les stockant temporairement pour les utiliser ou les modifier plus tard.
Les variables peuvent contenir différents types de données, selon leur nature et leur usage. Les types courants incluent :
- Entier : un nombre sans partie décimale, comme 5, -12 ou 0.
- Réel : un nombre avec une partie décimale, comme 3.14, -0.001 ou 10.4.
- Booléen : une valeur logique qui peut être soit vrai, soit faux.
- Chaîne de caractères : une séquence de caractères, comme “bonjour” ou “INF1220”.
Dans le pseudocode, le type de la variable est souvent implicite, mais il est essentiel de comprendre quel type de donnée une variable contient pour éviter des erreurs lors de la manipulation. Une variable doit être nommée de manière claire et descriptive (par exemple, age, somme, notes). On lui attribue une valeur à l’aide de l’opérateur d’affectation, souvent représenté par ← ou =. Par exemple :
age ← 18
somme ← 0
Ici, la variable age reçoit la valeur entière 18, et somme reçoit la valeur entière 0.
Considérons un algorithme simple qui calcule le carré d’un nombre entré par l’utilisateur :
lire nombre
carre ← nombre * nombre
écrire carre
Dans cet exemple :
nombreest une variable qui stocke la valeur entrée (par exemple, un réel comme 4.5).carreest une variable qui stocke le résultat de l’opérationnombre * nombre(par exemple, 20.25 sinombrevaut 4.5).- L’instruction
écrire carreaffiche la valeur de la variablecarre.
Chaque variable doit avoir un nom distinct dans un algorithme pour éviter toute confusion.
Il est recommandé d’initialiser une variable (lui donner une valeur de départ) avant de l’utiliser, pour éviter des comportements imprévisibles. Par exemple, avant d’additionner des nombres dans une variable somme, on écrit souvent somme ← 0.
Certaines variables ont une une portée et elles ne sont accessibles que dans la partie de l’algorithme où elles sont définies. Par exemple, nous
nous pouvons utiliser la valeur de la variable somme avant de lui avoir assigné une valeur (somme ← 0).
Les variables sont essentielles pour écrire des algorithmes flexibles et réutilisables. Elles permettent de travailler avec des données qui varient, comme des entrées utilisateur ou des résultats intermédiaires, et de suivre l’état d’un algorithme tout au long de son exécution. En pseudocode, les variables servent à rendre les instructions claires et compréhensibles, tout en préparant la transition vers un langage de programmation réel.
Pour illustrer simplement la déclaration et l’affectation d’une variable, voici comment on déclare une variable nommée age et on lui assigne la valeur 18 dans différents langages.
En Java, la déclaration exige de préciser le type :
int age = 18; // déclaration et affectation en une seule ligne
En JavaScript, le type est inféré automatiquement :
let age = 18; // déclaration et affectation
En Go, on peut utiliser la déclaration courte quand le type est évident :
age := 18 // déclaration et affectation, type int inféré
Ou de manière plus explicite :
var age int = 18
En C++, le type doit aussi être indiqué explicitement :
int age = 18; // déclaration et affectation
Ces lignes montrent la forme la plus basique de création et d’initialisation d’une variable, équivalente à l’instruction age ← 18 du pseudocode. La syntaxe varie légèrement selon le langage, mais le principe reste identique : nommer un espace mémoire et y placer une valeur.
Logique booléenne #
Un des fondements des algorithmes est la logique booléenne. Elle permet de manipuler des valeurs logiques, appelées booléennes, qui ne peuvent prendre que deux états : vrai ou faux. Ces valeurs sont utilisées pour prendre des décisions, contrôler le flux d’un algorithme ou évaluer des conditions dans des structures comme les boucles et les embranchements.
Les principaux opérateurs booléens sont décrits ci-dessous, accompagnés de leur table de vérité, qui montre le résultat de chaque opération pour toutes les combinaisons possibles des entrées A et B.
| A | B | NON A | A ET B | A OU B |
|---|---|---|---|---|
| vrai | vrai | faux | vrai | vrai |
| vrai | faux | faux | faux | vrai |
| faux | vrai | vrai | faux | vrai |
| faux | faux | vrai | faux | faux |
- NON A : l’inverse de A (négation)
- A ET B : vrai seulement si A et B sont vrais
- A OU B : vrai si au moins un des deux est vrai
En informatique, nous utilisons le plus souvent l’anglais.
- NON A : NOT A
- A ET B : A AND B
- A OU B : A OR B
Exemple 1 : Contrôle d’accès selon l’âge #
lire age
SI age >= 18 ALORS
    écrire "Accès autorisé"
SINON
    écrire "Accès refusé"
FIN SI
Ce pseudocode décrit un algorithme simple de contrôle d’accès basé sur l’âge d’une personne. L’instruction lire age récupère une valeur (l’âge) entrée par l’utilisateur ou une source externe, stockée dans la variable age. Une structure conditionnelle (SI … ALORS … SINON) vérifie si age est supérieur ou égal à 18. Si la condition est vraie (age >= 18), l’algorithme affiche le message “Accès autorisé”, indiquant que la personne est majeure et peut accéder à une ressource ou un lieu. Sinon, si age est inférieur à 18, il affiche “Accès refusé”, signalant que l’accès est interdit. L’algorithme se termine après l’affichage.
La logique booléenne est essentielle pour écrire des conditions dans les algorithmes. Par exemple, dans une structure conditionnelle ou une boucle, les opérateurs booléens permettent de combiner plusieurs critères. Voici un exemple en pseudocode pour vérifier si une personne peut voter :
lire age
lire est_citoyen
SI age >= 19 ET est_citoyen = vrai ALORS
    écrire "Vous pouvez voter"
SINON
    écrire "Vous ne pouvez pas voter"
FIN SI
Ici, la condition age >= 19 ET est_citoyen = vrai utilise l’opérateur ET pour vérifier que deux critères sont remplis avant d’autoriser le vote.
Lorsqu’on combine plusieurs opérateurs booléens, il est important de connaître leur ordre de priorité :
- NON (évalué en premier).
- ET.
- OU (évalué en dernier). Pour éviter toute ambiguïté, on utilise des parenthèses pour préciser l’ordre des opérations. Par exemple :
vrai ET faux OU vrai
Sans parenthèses, ET est évalué avant OU, donc cela donne (vrai ET faux) OU vrai, qui vaut faux OU vrai, soit vrai. Avec des parenthèses, on peut changer le résultat : vrai ET (faux OU vrai) donne vrai ET vrai, soit vrai.
Pour renforcer votre compréhension, utilisez l’application suivante.
En maîtrisant la logique booléenne, vous serez mieux équipé pour concevoir des algorithmes clairs et efficaces, en particulier lorsqu’il s’agit de prendre des décisions complexes basées sur plusieurs conditions.
Exemple 2 : Vérifier si un nombre est dans un intervalle #
lire x
SI x >= 10 ET x <= 20 ALORS
    écrire "x est dans l'intervalle [10, 20]"
SINON
    écrire "x n'est pas dans l'intervalle"
FIN SI
Ce pseudocode décrit un algorithme qui vérifie si une valeur entrée se situe dans l’intervalle fermé [10, 20]. L’instruction lire x récupère une valeur (un nombre, supposé réel ou entier) entrée par l’utilisateur, stockée dans la variable x. Une structure conditionnelle (SI … ALORS … SINON) évalue si x satisfait deux conditions combinées par l’opérateur ET : x >= 10 (x est supérieur ou égal à 10) et x <= 20 (x est inférieur ou égal à 20). Si les deux conditions sont vraies, c’est-à-dire si x est dans l’intervalle [10, 20], l’algorithme affiche “x est dans l’intervalle [10, 20]”. Sinon, si x est inférieur à 10 ou supérieur à 20, il affiche “x n’est pas dans l’intervalle”. L’algorithme se termine après l’affichage.
graph TD
    A[Lire x] --> B{x >= 10 ET x <= 20 ?}
    B -- Vrai --> C["x est dans l'intervalle"]
    B -- Faux --> D["x n'est pas dans l'intervalle"]
    C --> E[Fin]
    D --> E
Notation des programmeurs #
Pour des raisons historiques, les programmeurs remplacent souvent ET par &&, OU par || et
NON par !. C’est le cas notamment en Java.
Utilisez l’application suivante pour tester votre compréhension.
Calculateur d'expressions booléennes
La boucle #
Un algorithme prend habituellement des données et produit un résultat. Par exemple, un algorithme cherchant à déterminer si un nombre est pair, pourra recevoir un nombre en paramètre et il pourra produire comme réponse une valeur booléenne (vrai ou faux). Un même algorithme va donc généralement pouvoir être exécuté sur différentes données et pouvoir fournir des réponses différentes. En ce sens, une fonction (au sens mathématique) comme f(x) = a x + b peut être décrite comme étant un algorithme. Une fonction doit toujours produire la même valeur étant données les mêmes données. Un algorithme n’est pas limité de cette manière. Par exemple, un algorithme pourrait servir à choisir un nom aléatoirement au sein d’une liste. D’une exécution à l’autre, l’algorithme pourrait produire des valeurs différentes avec les mêmes données.
La plupart des algorithmes en pratique sont itératifs. Une itération est la répétition d’un processus. Si vous devez teindre une clôture, vous allez peut-être teindre chaque planche une à une. Nous dirons alors que vous itérez sur les planches. Mais comment saurez-vous où vous êtes rendu si vous prenez une pause? Peut-être pourrez-vous poser un petit drapeau sur la planche que vous êtes en train de teindre. On dira alors que le drapeau est un itérateur, c’est-à-dire un indicateur de votre progrès dans votre itération. À chaque étape où vous déplacez le drapeau d’une planche à l’autre, nous pourrons dire que vous incrémentez la position du drapeau. Si jamais vous deviez faire un retour à la planche précédente, nous dirons que vous décrémentez le drapeau. En informatique, nous n’utilisons pas de drapeaux physiques. Pour savoir où on est rendu, on utilise des compteurs, le plus souvent des valeurs entières. Quand on dit qu’on incrémente un entier, on veut généralement dire qu’on ajoute “1” à sa valeur.
Nous obtenons alors la notion de boucle: nous effectuons une tâche donnée tant qu’une condition n’est pas satisfaite. Cette vidéo présente le concept de boucle.
En informatique, on fait souvent référence à la notion d’impression à l’écran. Le plus souvent cela fait référence à l’affichage à l’écran d’un message ou d’un texte.
Pour illustrer concrètement ces concepts, considérons un exemple simple : afficher les nombres de 1 à 10 à l’écran, en utilisant une boucle qui incrémente un compteur à chaque itération. Cela montre comment un compteur agit comme un itérateur et comment la boucle répète l’impression jusqu’à ce que la condition soit satisfaite.
En Java, une boucle for classique s’écrit ainsi :
for (int i = 1; i <= 10; i++) {
    System.out.println(i);
}
Ici, i est initialisé à 1, la boucle continue tant que i est inférieur ou égal à 10, et i est incrémenté de 1 à chaque tour.
En JavaScript, la syntaxe est très similaire :
for (let i = 1; i <= 10; i++) {
    console.log(i);
}
La différence principale réside dans l’utilisation de let pour déclarer la variable i, ce qui limite sa portée à la boucle.
En Go, on utilise également une boucle for (la seule structure de boucle disponible dans le langage) :
for i := 1; i <= 10; i++ {
    fmt.Println(i)
}
L’initialisation, la condition et l’incrémentation sont regroupées dans l’en-tête de la boucle, comme dans les langages précédents.
En C++, la boucle for prend une forme proche de celle de Java :
#include <iostream>

for (int i = 1; i <= 10; i++) {
    std::cout << i << std::endl;
}
Ces exemples montrent à quel point le concept de boucle avec compteur est universel dans les langages impératifs, même si les syntaxes varient légèrement. Dans tous les cas, l’impression à l’écran (via println, console.log, fmt.Println ou cout) est répétée 10 fois, en incrémentant l’itérateur à chaque passage. Cet usage évite d’écrire manuellement dix instructions d’impression identiques, rendant le code plus concis et plus facile à modifier (par exemple, pour changer la borne supérieure).
Tableau #
Un tableau est une structure de données qui permet de stocker plusieurs éléments, comme des nombres ou des chaînes de caractères, dans une seule variable. Ces éléments sont organisés séquentiellement et accessibles via un indice, un nombre entier qui indique leur position. Par exemple, dans un tableau nommé tableau, l’élément à la position 1 est noté tableau[1], celui à la position 2 est tableau[2], et ainsi de suite. La taille du
tableau est normalement fixée et connue.
La numérotation des indices varie selon les langages de programmation ou les contextes. Dans de nombreux langages comme C, Java ou Python, les indices commencent à 0 : le premier élément est tableau[0], le deuxième tableau[1], etc. Cette convention, dite « base 0 », est courante en informatique pour des raisons techniques liées à la gestion de la mémoire. Dans d’autres contextes, comme certaines notations mathématiques ou langages comme Lua, les indices débutent à 1, ce qui peut être plus intuitif pour des utilisateurs non techniques. Le choix de l’index de départ dépend donc du système utilisé, et il est crucial de connaître cette convention pour manipuler correctement les éléments d’un tableau. La convention utilisée est souvent
claire selon le contexte.
Tous les langages de programmation supportent les tableaux.
En Java, nous pouvons créer un tableau d’entiers comprenant 5 éléments comme suit.
int [] tableau = new int[5];
Dans ce cas, le tableau comprendra la valeur 0 répétée 5 fois.
Nous pouvons aussi initialiser un tableau avec les entiers 1,2,3 comme suit.
int [] tableau = {1, 2, 3};
En JavaScript, la syntaxe équivalente est celle-ci.
let tableau = Array(5).fill(0);
let tableau = [1, 2, 3];
En Go, nous utiliserions la syntaxe suivante.
tableau := make([]int, 5)
tableau := []int{1, 2, 3}
En C++, nous pourrions faire l’équivalent.
int tableau[5]{};
int tableau[]{1, 2, 3};
Dans tous ces langages, l’expression tableau[0] fait référence au premier élément du tableau.
Exemple : Calcul de la moyenne #
Pour illustrer la notion de pseudocode, commençons par un exemple relativement simple. Supposons que nous avons un tableau de notes (par ex., les notes 10.4, 12.6, 18.7, 5.0) et que nous désirons calculer la moyenne. On utilise le convention que si le tableau se nomme ’notes’, alors la première note (par ex., 10.4) est notes[0], la seconde note est notes[1]… et ainsi de suite jusqu’à notes[3]. Évidemment, dans ce cas, on sait qu’il y’a 4 notes, mais il plus pratique d’écrire le pseudocode de manière générale. On fera donc référence à la longueur du tableau (au nombre d’éléments qu’il contient) comme étant un paramètre. Pour visiter tous les éléments, on peut initialiser une valeur entière à 0, et l’incrémenter de 1 tant qu’elle demeure plus petite que la longueur du tableau.
graph TD
    A[Début] --> B[Initialiser iterateur = 0, moyenne = 0]
    B --> C{iterateur < longueur de notes ?}
    C -- Vrai --> D["moyenne = moyenne + notes[iterateur]"]
    D --> E[iterateur = iterateur + 1]
    E --> C
    C -- Faux --> F[moyenne = moyenne / longueur de notes]
    F --> G[Afficher moyenne]
    G --> H[Fin]
Utilisez l’application suivante pour explorer l’exécution de l’algorithme.
Ce pseudocode calcule la moyenne de quatre nombres rationnels stockés dans un tableau notes. Une variable iterateur est initialisée à 0 pour parcourir le tableau, et une variable moyenne est initialisée à 0 pour accumuler la somme des éléments. La boucle (TANT QUE iterateur < la longueur de notes FAIRE) itère tant que iterateur est inférieur à la longueur du tableau (ici, 4). À chaque itération, l’élément notes[iterateur] est ajouté à moyenne, et iterateur est incrémenté de 1. Une fois la boucle terminée, la somme totale des éléments est stockée dans moyenne. Enfin, moyenne est divisée par la longueur du tableau (moyenne = moyenne / la longueur de notes) pour obtenir la moyenne arithmétique. Le résultat, un nombre rationnel, est la sortie.
Calcul de la moyenne
Entrez un tableau de nombres rationnels séparés par des virgules et exécutez le pseudocode pour calculer la moyenne.
Pseudocode
Tableau de quatre nombres rationnels : notes
Variables :
  Nombre entier : iterateur = 0
  Nombre rationnel : moyenne = 0
Sorties :
  Nombre rationnel : moyenne
TANT QUE iterateur < la longueur de notes FAIRE
    moyenne = moyenne + notes[iterateur]
    iterateur = iterateur + 1
FIN TANT QUE
moyenne = moyenne / la longueur de notes
État
Tableau : []
Itérateur : 0
Moyenne : 0
Observez comment on termine la boucle “TANT QUE” avec une ligne “FIN TANT QUE”. Ce n’est pas nécessaire, mais vous devez être clair et précis quant au début et à la fin de vos opérations. On peut aussi indiquer le début et la fin d’une boucle avec l’indentation, ou tout autre moyen compris par les êtres humains. L’expression “TANT QUE” est associée à une condition qui peut être vraie ou fausse. L’exécution se poursuit tant que l’expression est vraie, et elle se termine lorsque l’expression est fausse.
Pour montrer comment ce pseudocode se traduit dans des langages réels, considérons un tableau contenant les notes {10.4, 12.6, 18.7, 5.0} et calculons sa moyenne en utilisant une boucle qui parcourt les indices.
En Java, on utilise un tableau ou un ArrayList, mais ici avec un tableau fixe :
double[] notes = {10.4, 12.6, 18.7, 5.0};
double somme = 0;
for (int i = 0; i < notes.length; i++) {
    somme += notes[i];
}
double moyenne = somme / notes.length;
System.out.println(moyenne);
En JavaScript, les tableaux sont dynamiques et la propriété length donne directement la taille :
let notes = [10.4, 12.6, 18.7, 5.0];
let somme = 0;
for (let i = 0; i < notes.length; i++) {
    somme += notes[i];
}
let moyenne = somme / notes.length;
console.log(moyenne);
En Go, on utilise un slice et la fonction len pour obtenir la longueur :
notes := []float64{10.4, 12.6, 18.7, 5.0}
somme := 0.0
for i := 0; i < len(notes); i++ {
    somme += notes[i]
}
moyenne := somme / float64(len(notes))
fmt.Println(moyenne)
En C++, on peut utiliser un std::vector ou un tableau classique ; ici avec un initializer list et un vector :
#include <iostream>
#include <vector>

std::vector<double> notes = {10.4, 12.6, 18.7, 5.0};
double somme = 0;
for (size_t i = 0; i < notes.size(); i++) {
    somme += notes[i];
}
double moyenne = somme / notes.size();
std::cout << moyenne << std::endl;
Dans chaque cas, la structure reste fidèle au pseudocode : initialisation d’une somme à zéro, parcours des indices de 0 à longueur-1 avec incrémentation, accumulation des valeurs, puis division finale par le nombre d’éléments. Cette approche rend l’algorithme indépendant de la taille exacte du tableau, exactement comme souhaité dans la version générale en pseudocode.
Exemple : L’algorithme d’Euclide #
Le deuxième exemple est nettement plus ancien : il est décrit dans les Éléments d’Euclide, vers 300 avant notre ère. C’est le plus vieil algorithme non trivial qui nous soit parvenu, et il précède l’invention de l’ordinateur d’environ vingt-trois siècles. Il montre bien qu’un algorithme est une idée indépendante de la machine qui l’exécute.
Le problème est de trouver le plus grand commun diviseur (PGCD) de deux entiers positifs : le plus grand nombre qui les divise tous les deux sans laisser de reste. Le PGCD de 48 et 18 vaut 6, parce que 6 divise 48 (huit fois) et 18 (trois fois), et qu’aucun nombre plus grand ne fait mieux.
Une première approche vient naturellement à l’esprit : essayer tous les nombres, du plus petit des deux jusqu’à 1, et s’arrêter au premier qui divise les deux.
lire a
lire b
d ← le plus petit de a et b
TANT QUE d > 0 FAIRE
    SI a mod d = 0 ET b mod d = 0 ALORS
        retourner d
    FIN SI
    d ← d - 1
FIN TANT QUE
L’opération mod donne le reste de la division entière : 48 mod 18 vaut 12, puisque 48 = 2 × 18 + 12. Un reste nul signifie donc une division exacte.
Cet algorithme fonctionne, mais il est lent : pour deux nombres proches d’un million dont le PGCD est 1, il faut parcourir presque un million de valeurs avant de conclure.
Euclide procède tout autrement. Son idée tient en une seule observation : si un nombre divise à la fois \( a \) et \( b \), alors il divise aussi le reste de la division de \( a \) par \( b \). Les deux paires \( (a, b) \) et \( (b, a \bmod b) \) ont donc exactement les mêmes diviseurs communs, et en particulier le même PGCD. Comme le reste est toujours plus petit que \( b \), on remplace le problème par un problème strictement plus petit, encore et encore, jusqu’à ce que le reste devienne nul.
lire a
lire b
TANT QUE b ≠ 0 FAIRE
    reste ← a mod b
    a ← b
    b ← reste
FIN TANT QUE
retourner a
Suivons l’exécution avec \( a = 1071 \) et \( b = 462 \) :
| a | b | a mod b |
|---|---|---|
| 1071 | 462 | 147 |
| 462 | 147 | 21 |
| 147 | 21 | 0 |
| 21 | 0 | — |
Dès que b vaut 0, la réponse se trouve dans a : le PGCD de 1071 et 462 est 21. Trois tours de boucle ont suffi.
graph TD
    A[Début] --> B[Lire a et b]
    B --> C{b ≠ 0 ?}
    C -- Vrai --> D["reste = a mod b"]
    D --> E["a = b"]
    E --> F["b = reste"]
    F --> C
    C -- Faux --> G[Afficher a]
    G --> H[Fin]
Utilisez l’application suivante pour exécuter l’algorithme sur les nombres de votre choix, soit pas à pas, soit d’un seul coup.
L'algorithme d'Euclide
Choisissez deux entiers positifs, puis exécutez l'algorithme pas à pas ou d'un seul coup pour obtenir leur plus grand commun diviseur.
Entiers de 1 à 1 000 000 000.
Pseudocode
État des variables
- a : 1071
- b : 462
- reste : —
- Tours de boucle : 0
Prêt. L'algorithme n'a pas encore commencé.
| Tour | a | b | a mod b |
|---|---|---|---|
| Aucune division effectuée pour l'instant. | |||
Remarquez que l’algorithme n’a besoin d’aucun tableau et d’aucune mémoire supplémentaire : trois variables suffisent, quelle que soit la taille des nombres. Remarquez aussi qu’il fonctionne même si on lui donne les deux nombres dans le mauvais ordre. Avec \( a = 18 \) et \( b = 48 \), le premier tour calcule 18 mod 48, qui vaut 18, puis échange les deux valeurs : la paire devient (48, 18) et tout rentre dans l’ordre. Une seule itération est perdue.
Ce qui frappe surtout, c’est la rapidité. La méthode naïve peut exiger un million d’itérations pour des nombres d’un million ; l’algorithme d’Euclide, lui, n’en demande jamais plus de vingt-huit. Le nombre de divisions croît comme le logarithme du plus petit des deux nombres : doubler la taille des entrées n’ajoute qu’une poignée d’étapes.
Avant d’aller plus loin, il faut présenter une suite de nombres qui va réapparaître ici : les nombres de Fibonacci. Décrits par Leonardo Fibonacci en 1202, ils se construisent selon une règle très simple : les deux premiers valent 1, et chaque nombre suivant est la somme des deux qui le précèdent. On obtient ainsi 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, et ainsi de suite : 1 + 1 = 2, puis 1 + 2 = 3, puis 2 + 3 = 5, puis 3 + 5 = 8. La suite grandit de plus en plus vite, chaque terme valant environ 1,618 fois le précédent. En poursuivant assez longtemps, on rencontre 6765 puis 10946, deux termes consécutifs.
En 1844, Gabriel Lamé a précisé ce comportement : le nombre de divisions ne dépasse jamais cinq fois le nombre de chiffres du plus petit des deux nombres. Il a aussi identifié le pire cas, et il est inattendu : ce sont justement deux nombres de Fibonacci consécutifs. Le calcul du PGCD de 10946 et 6765 demande dix-neuf divisions, un record pour des nombres de cette taille. Ce résultat est considéré comme l’un des premiers de l’histoire à analyser le coût d’un algorithme plutôt que sa simple correction, un thème que nous reprendrons en détail plus loin dans le cours.
Exemple : Les algorithmes de l’école primaire #
Vous connaissiez déjà des algorithmes bien avant ce cours. L’addition posée, la multiplication en colonnes et la division longue en sont trois, et vous les avez exécutés des centaines de fois à la main. Ce sont des algorithmes au sens plein du terme : chaque étape est décrite sans ambiguïté, le nombre d’étapes est fini, et la méthode fonctionne pour n’importe quels nombres, pas seulement pour ceux de l’exercice.
Ce n’est pas un hasard si ces méthodes réapparaissent ici. Le mot algorithme vient du nom du mathématicien Muhammad ibn Mūsā al-Khwārizmī, qui rédigea vers 825 un traité expliquant comment calculer avec les chiffres indo-arabes et la notation positionnelle. Traduit en latin au XIIe siècle sous le titre Algoritmi de numero Indorum, il donna son nom à la discipline. Pendant des siècles, en Europe, « algorisme » a désigné précisément cela : poser ses calculs en colonnes avec des chiffres, par opposition au calcul sur abaque avec des jetons. Les algorithmes que vous avez appris à l’école sont donc les algorithmes originaux.
Pour les décrire en pseudocode, il faut d’abord représenter les nombres. Un nombre écrit en décimal est une suite de chiffres, donc un tableau. Nous adoptons la convention suivante : a[0] est le chiffre des unités, a[1] celui des dizaines, a[2] celui des centaines, et ainsi de suite. Le tableau est donc écrit à l’envers par rapport à la façon dont on écrit le nombre sur une feuille, mais l’indice correspond alors exactement à la puissance de 10 associée au chiffre, ce qui simplifie tout. Le nombre 478 devient le tableau [8, 7, 4].
Nous utiliserons deux opérations sur les entiers : mod, déjà rencontré, qui donne le reste de la division entière, et div, qui en donne le quotient. Ainsi 14 mod 10 vaut 4 et 14 div 10 vaut 1. Autrement dit, pour un nombre de deux chiffres, mod 10 extrait le chiffre des unités et div 10 extrait la retenue.
L’addition posée #
La règle apprise à l’école tient en une phrase : on additionne colonne par colonne, de droite à gauche, et lorsque la somme d’une colonne dépasse 9, on écrit le chiffre des unités et on reporte une retenue sur la colonne suivante. Supposons que les deux nombres ont n chiffres chacun ; si l’un est plus court, on le complète par des zéros à gauche, exactement comme on le ferait au tableau.
lire a          // tableau de n chiffres, a[0] = les unités
lire b          // tableau de n chiffres, b[0] = les unités
retenue ← 0
i ← 0
TANT QUE i < n FAIRE
    s ← a[i] + b[i] + retenue
    resultat[i] ← s mod 10
    retenue ← s div 10
    i ← i + 1
FIN TANT QUE
resultat[n] ← retenue
retourner resultat
Suivons l’exécution avec 478 + 356 :
| i | a[i] | b[i] | retenue entrante | s | resultat[i] | retenue sortante |
|---|---|---|---|---|---|---|
| 0 | 8 | 6 | 0 | 14 | 4 | 1 |
| 1 | 7 | 5 | 1 | 13 | 3 | 1 |
| 2 | 4 | 3 | 1 | 8 | 8 | 0 |
La dernière retenue vaut 0, donc resultat[3] vaut 0 et le résultat est 834.
graph TD
    A[Début] --> B["Lire a et b, retenue = 0, i = 0"]
    B --> C{i < n ?}
    C -- Vrai --> D["s = a[i] + b[i] + retenue"]
    D --> E["resultat[i] = s mod 10"]
    E --> F["retenue = s div 10"]
    F --> G["i = i + 1"]
    G --> C
    C -- Faux --> H["resultat[n] = retenue"]
    H --> I[Afficher resultat]
    I --> J[Fin]
Deux remarques. D’abord, la retenue ne dépasse jamais 1 : la somme d’une colonne vaut au plus 9 + 9 + 1, soit 19. Ensuite, le nombre d’étapes est exactement le nombre de chiffres. Additionner deux nombres de mille chiffres demande mille tours de boucle, deux fois plus que pour cinq cents chiffres. C’est cette proportionnalité directe qui rend l’addition bon marché, et c’est précisément l’algorithme que votre ordinateur exécute, à ceci près qu’il travaille en base 2 plutôt qu’en base 10.
La multiplication posée #
La multiplication en colonnes procède en deux temps : on multiplie le premier nombre par chacun des chiffres du second, en décalant chaque ligne d’un rang vers la gauche, puis on additionne toutes les lignes obtenues. En pseudocode, on peut faire les deux à la fois en accumulant directement dans le tableau du résultat. Le fameux décalage d’un rang n’est alors rien d’autre que l’indice i + j : le produit du chiffre de rang i par le chiffre de rang j contribue au rang i + j, ce qui traduit le fait que multiplier des dizaines par des centaines donne des milliers.
lire a          // n chiffres
lire b          // m chiffres
POUR TOUT indice k de 0 à n + m - 1 FAIRE
    resultat[k] ← 0
FIN POUR
i ← 0
TANT QUE i < n FAIRE
    retenue ← 0
    j ← 0
    TANT QUE j < m FAIRE
        s ← resultat[i + j] + a[i] × b[j] + retenue
        resultat[i + j] ← s mod 10
        retenue ← s div 10
        j ← j + 1
    FIN TANT QUE
    resultat[i + m] ← retenue
    i ← i + 1
FIN TANT QUE
retourner resultat
Suivons l’exécution avec 23 × 45, donc a = [3, 2] et b = [5, 4] :
| i | j | resultat[i+j] avant | a[i] × b[j] | retenue entrante | s | resultat[i+j] après | retenue sortante |
|---|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 15 | 0 | 15 | 5 | 1 |
| 0 | 1 | 0 | 12 | 1 | 13 | 3 | 1 |
| 1 | 0 | 3 | 10 | 0 | 13 | 3 | 1 |
| 1 | 1 | 1 | 8 | 1 | 10 | 0 | 1 |
Après le premier passage, resultat[2] reçoit la retenue 1 ; après le second, resultat[3] reçoit la retenue 1. Le tableau final est [5, 3, 0, 1], c’est-à-dire 1035.
Le coût n’est plus le même que pour l’addition. Chaque chiffre du premier nombre rencontre chaque chiffre du second : multiplier deux nombres de n chiffres demande \( n^2 \) multiplications élémentaires. Doubler la taille des nombres quadruple le travail. Pour deux nombres de mille chiffres, cela fait un million d’opérations, contre mille pour l’addition.
On a longtemps cru que c’était inévitable. En 1960, Andreï Kolmogorov énonça devant un séminaire de Moscou la conjecture qu’aucune méthode ne pouvait faire mieux que \( n^2 \). Anatoli Karatsuba, alors étudiant, la réfuta en une semaine avec une méthode en \( n^{1{,}58} \) environ, obtenue en remplaçant une des multiplications par des additions. La méthode de l’école, vieille de mille ans, n’était donc pas optimale. Nous reviendrons sur cette façon de mesurer le coût d’un algorithme plus loin dans le cours.
La division longue #
La division longue est la plus laborieuse des trois, et c’est aussi la plus intéressante. Contrairement aux deux autres, elle se déroule de gauche à droite, en partant du chiffre le plus significatif du dividende. À chaque étape, on abaisse un chiffre à côté du reste courant, on cherche combien de fois le diviseur entre dans le nombre ainsi formé, on écrit ce chiffre au quotient, et on garde le reste.
Le pseudocode ci-dessous divise un dividende a de n chiffres par un diviseur d, un entier positif. L’indice n - 1 désigne le chiffre le plus à gauche, celui par lequel on commence.
lire a          // dividende, tableau de n chiffres, a[0] = les unités
lire d          // diviseur, un entier positif
reste ← 0
i ← n - 1
TANT QUE i ≥ 0 FAIRE
    courant ← reste × 10 + a[i]
    quotient[i] ← courant div d
    reste ← courant mod d
    i ← i - 1
FIN TANT QUE
retourner quotient et reste
Suivons l’exécution avec 1234 ÷ 7, donc a = [4, 3, 2, 1] :
| i | reste entrant | a[i] | courant | quotient[i] | reste sortant |
|---|---|---|---|---|---|
| 3 | 0 | 1 | 1 | 0 | 1 |
| 2 | 1 | 2 | 12 | 1 | 5 |
| 1 | 5 | 3 | 53 | 7 | 4 |
| 0 | 4 | 4 | 44 | 6 | 2 |
Le quotient est [6, 7, 1, 0], c’est-à-dire 0176, soit 176, et le reste est 2. On vérifie que 7 × 176 + 2 = 1234. Le zéro de tête est celui que l’écolier n’écrit pas.
L’opération courant div d mérite qu’on s’y arrête. Le pseudocode la traite comme une opération élémentaire, mais à l’école, c’est vous qui la réalisiez, et par tâtonnement : « combien de fois 7 entre-t-il dans 53 ? ». Vous essayiez mentalement quelques multiples jusqu’à trouver le bon. Autrement dit, cette ligne cache elle-même une recherche. On pourrait la rendre explicite en remplaçant la division par des soustractions répétées :
c ← 0
TANT QUE courant ≥ d FAIRE
    courant ← courant - d
    c ← c + 1
FIN TANT QUE
quotient[i] ← c
reste ← courant
Cette boucle s’exécute au plus neuf fois, puisque courant est toujours inférieur à dix fois d. C’est un premier exemple d’une situation qui reviendra souvent : ce qu’on tient pour une opération unique se révèle, en y regardant de plus près, être un algorithme à part entière.
Ces trois algorithmes valent surtout comme point de repère. Ils montrent que la difficulté du pseudocode n’est pas de trouver des idées nouvelles, mais d’écrire avec une précision suffisante des méthodes que l’on connaît déjà. Vous savez additionner depuis longtemps ; l’exercice consiste à l’expliquer si complètement qu’une machine dépourvue d’intuition puisse suivre vos instructions à la lettre. C’est exactement ce que vous faisiez, enfant, en appliquant mécaniquement une règle apprise sans la comprendre entièrement : vous jouiez le rôle de l’ordinateur.